- 对齐(Alignment) 会保留你提供的歌词,并找出每个词在何时被唱出。
- 转写(Transcription) 会聆听演唱内容,写出歌词,并为这些 词进行时间标注。
快速选择
转写模型
AudioShake
AudioShake 会对录制的演唱进行转写,并显示为中等成本档位。 结果会因录音、语言、人声与混音而异,因此当首次结果需要大量修正时, 建议对比不同模型。ElevenLabs Scribe
ElevenLabs Scribe 会基于原始演唱生成带时间标注的歌词。应用中 显示为低成本档位,支持 Auto-detect,并接受范围广泛的语言 提示。在某些歌曲上,它可能比 AudioShake 给出更好的初稿并 需要更少的修正,因此当其他模型效果不佳时值得一试。 如果你提供歌词,Scribe 会用它们来提升词汇识别效果。它 不会逐词对齐该文本,因此请检查生成的词语与分行 分组。若必须保持提供的文本完全不变,请使用对齐模型。MusicAI
MusicAI 是另一种适用于人声清晰歌曲的转写选项。应用中 显示四个质量点与高成本档位。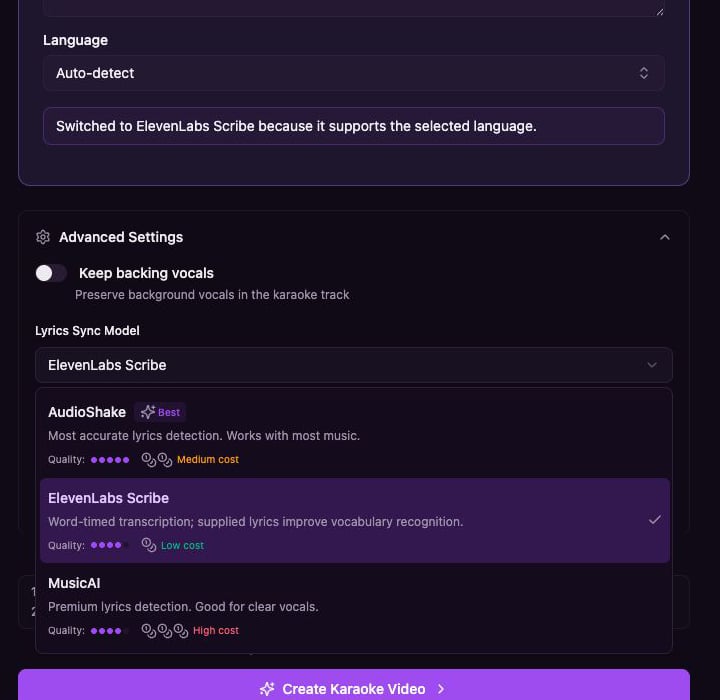
对齐模型
当你已经拥有正确歌词并希望 Youka 将 这些词放到时间轴上时,请使用对齐。- AudioShake alignment 会在将歌词放到时间轴上的同时,保留 所提供的歌词文本。
- MusicAI alignment 在所选工作流可用时,提供替代的逐词或子词级时间标注 。