- **정렬(Alignment)**은 사용자가 제공한 가사를 유지하면서 각 단어가 언제 불리는지 찾습니다.
- **전사(Transcription)**는 공연을 듣고 가사를 작성한 뒤 단어의 타이밍을 맞춥니다.
빠른 선택
전사 모델
AudioShake
AudioShake는 녹음된 퍼포먼스를 전사하며, 앱에서는 중간 비용 티어로 표시됩니다. 결과는 녹음 상태, 언어, 보컬, 믹스에 따라 달라질 수 있으므로 첫 결과에 대폭적인 수정이 필요하다면 모델을 비교해 보세요.ElevenLabs Scribe
ElevenLabs Scribe는 원본 퍼포먼스에서 타이밍이 포함된 가사를 생성합니다. 앱에서는 낮은 비용 티어로 표시되며, Auto-detect를 지원하고 폭넓은 언어 힌트를 받을 수 있습니다. 어떤 곡에서는 AudioShake보다 더 나은 1차 결과를 만들어 수정이 더 적을 수 있으므로, 다른 모델이 기대에 못 미칠 때 시도해 볼 가치가 있습니다. 가사를 제공하면 Scribe가 어휘 인식을 개선하는 데 이를 활용합니다. 다만 해당 텍스트를 단어 단위로 그대로 정렬하는 것은 아니므로, 결과 단어와 라인 그룹핑을 검토하세요. 제공한 텍스트가 변경되면 안 된다면 정렬 모델을 사용하세요.MusicAI
MusicAI는 보컬이 또렷한 곡을 위한 또 다른 전사 옵션입니다. 앱에서는 품질 점 4개와 높은 비용 티어로 표시됩니다.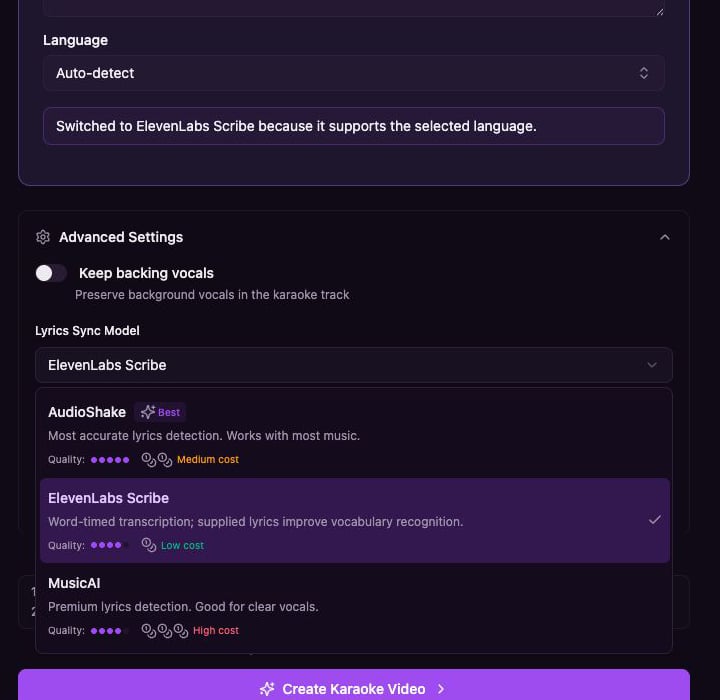
정렬 모델
이미 정확한 가사가 있고 Youka가 그 단어들을 타임라인에 배치하도록 하고 싶다면 정렬을 사용하세요.- AudioShake alignment는 제공된 가사 텍스트를 그대로 보존하면서 타임라인에 배치합니다.
- MusicAI alignment는 선택한 워크플로에서 사용 가능할 경우 대체 단어 단위 또는 서브워드 단위 타이밍을 제공합니다.